快速接入 DeepSeek API 开放平台
DeepSeek 提供了与 OpenAI 规范完全对齐的 RESTful 接口体系。您无需更换已有工程基建,仅需重定向 Base URL 与 Model 名称,即可将生产环境推理算力无缝迁移至 DeepSeek-R1 与 DeepSeek-V3 引擎。
# Python 示例:使用官方 openai-python SDK 直接调用 DeepSeek API
from openai import OpenAI
client = OpenAI(
api_key="sk-deepseek-official-apikey",
base_url="https://api.deepseek.com" # 站内闭环标准端点
)
response = client.chat.completions.create(
model="deepseek-reasoner", # 对应 DeepSeek-R1 纯强化学习推理模型
messages=[
{"role": "user", "content": "请推导三维不可压缩欧拉方程的动量守恒积分形式。"}
],
stream=True
)
for chunk in response:
# reasoning_content 输出完整自省思维链
if hasattr(chunk.choices[0].delta, 'reasoning_content'):
print(chunk.choices[0].delta.reasoning_content, end="")
调用费率与 Context Caching 机制
依托 Multi-head Latent Attention (MLA) 压缩架构与智能前缀缓存技术,DeepSeek API 为开发者带来了业界前所未有的超高性价比。命中缓存的 Prompt Token 费率直降 75% 以上。
| 模型型号 | 输入单价 (未命中缓存) | 输入单价 (命中缓存) | 输出单价 (含思考过程) |
|---|---|---|---|
| DeepSeek-R1 (推理) | ¥ 4.00 / 百万 Tokens | ¥ 1.00 / 百万 Tokens | ¥ 16.00 / 百万 Tokens |
| DeepSeek-V3 (通用) | ¥ 2.00 / 百万 Tokens | ¥ 0.50 / 百万 Tokens | ¥ 8.00 / 百万 Tokens |
DeepSeek Harness 自动化评测基准
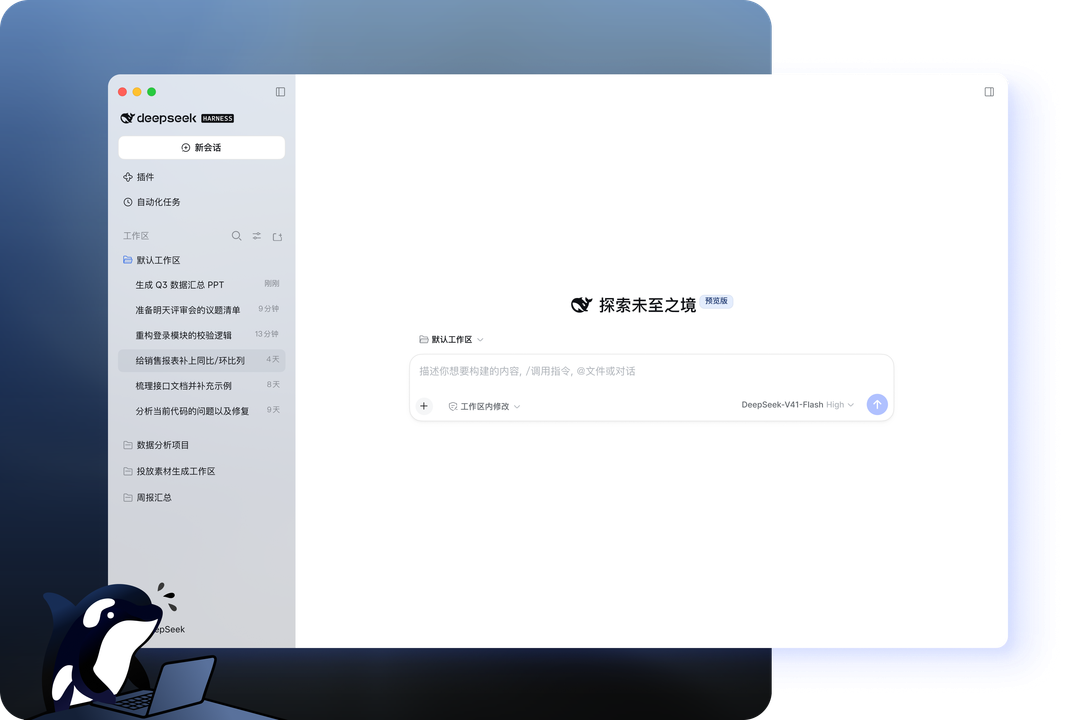
DeepSeek Harness 是深度求索开源的自动化大语言模型评测框架。支持 AIME、MATH-500、Codeforces、SWE-bench 等前沿学术与工程场景的自动化推理测试。
开发团队可使用 Harness 工具在私有领域数据集上自动化验证模型在真实工程任务下的逻辑严谨度与执行表现。
常见问题与排错方案
Q: 如何在流式传输中区分思考过程与最终回答?
A: DeepSeek-R1 会先在 delta.reasoning_content 字段逐步下发思维链,思考结束后再通过 delta.content 返回正式回复,客户端可分流渲染。
Q: 遇到并发限制 429 报错如何优化?
A: 推荐使用指数退避(Exponential Backoff)重试策略,或在极速通道页面获取不同节点镜像分流地址进行流量负载均衡。